
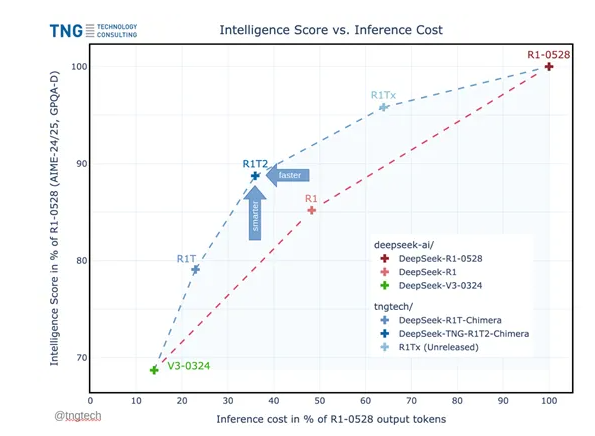
Kürzlich hat die bekannte deutsche Technikberatungsfirma TNG eine erweiterte Version von DeepSeek veröffentlicht – DeepSeek-TNG-R1T2-Chimera. Dies markiert einen weiteren bedeutenden Durchbruch in der Inferenzeffizienz und Leistungsfähigkeit von Tiefe-Lern-Modellen. Diese neue Version steigert nicht nur die Inferenzeffizienz um 200 %, sondern reduziert auch die Inferenzkosten durch die innovative AoE-Architektur erheblich.
Die innovative AoE-Architektur
Die Chimera-Version ist eine gemeinsame Entwicklung auf Basis der drei Modelle R1-0528, R1 und V3-0324 von DeepSeek und verwendet eine neue AoE-(Adaptive Expert)-Architektur. Diese Architektur optimiert die Mixture-of-Experts-(MoE)-Architektur detailliert und kann so effizienter mit den Modellparametern umgehen, wodurch die Inferenzleistung verbessert und die Token-Ausgabe gespart wird.
In mehreren gängigen Testbenchmarks (wie MTBench und AIME-2024) schneidet die Chimera-Version besser ab als die gewöhnliche R1-Version und zeigt deutlich bessere Inferenzfähigkeit und Wirtschaftlichkeit.
Vorteile der MoE-Architektur
Bevor wir die AoE-Architektur verstehen, müssen wir zunächst die Mixture-of-Experts-(MoE)-Architektur kennen lernen. Die MoE-Architektur teilt den Feed-Forward-Teil des Transformers in mehrere „Experten“ auf, und jeder Eingabemarkierung wird nur zu einem Teil der Experten weitergeleitet. Dieses Verfahren erhöht effektiv die Effizienz und Leistungsfähigkeit des Modells.
Zum Beispiel erreichte das 2023 von Mistral vorgestellte Mixtral-8x7B-Modell, obwohl es nur 1,3 Milliarden aktivierte Parameter hatte, eine Leistung, die mit dem LLaMA-2-70B-Modell mit 70 Milliarden Parametern konkurrieren konnte, und zeigte eine sechsfach höhere Inferenzgeschwindigkeit.
Die AoE-Architektur nutzt die feinkörnige Natur der MoE-Architektur, um Forschern zu ermöglichen, aus bestehenden MoE-Modellen spezifische Untermodelle zu erstellen. Durch Interpolation und selektive Kombination der Gewichtstensoren der Elternmodelle kann ein neues Modell erstellt werden, das nicht nur gute Eigenschaften beibehält, sondern auch flexibel an die tatsächlichen Anforderungen angepasst werden kann.
Forscher haben DeepSeek-V3-0324 und DeepSeek-R1 als Elternmodelle ausgewählt und verwenden verschiedene Feinabstimmungstechniken, um sicherzustellen, dass diese beiden Modelle hervorragende Inferenz- und Befehlsfolgefähigkeiten zeigen.
Gewichtsverknüpfung und Optimierung
Bei der Erstellung eines neuen Untermodells müssen Forscher zunächst die Gewichtstensoren der Elternmodelle vorbereiten und direkt mit den Gewichtsdateien arbeiten. Danach können Forscher durch Definition von Gewichtskoeffizienten glatt interpolieren und verknüpfen, um neue Modellvarianten zu generieren.
Während des Verknüpfungsprozesses führen Forscher Schwellenwertkontrollen und Unterschiedsscreening-Mechanismen ein, um sicherzustellen, dass nur dann relevante Tensoren in den Verknüpfungsprozess einbezogen werden, wenn sich die Unterschiede signifikant sind. Dies reduziert die Modellkomplexität und die Berechnungskosten.
In der MoE-Architektur ist der Router-Expertentensor ein entscheidender Bestandteil, der bestimmt, welcher Expertenmodul im Inferenzprozess ausgewählt wird. Das AoE-Verfahren konzentriert sich besonders auf die Verknüpfung dieser Tensoren. Forscher stellten fest, dass die Optimierung der Router-Expertentensoren die Inferenzfähigkeit des Untermodells erheblich verbessern kann.
Zuletzt realisierten Forscher die Modellverknüpfung über das PyTorch-Framework. Die verknüpften Gewichte wurden in einer neuen Gewichtsdatei gespeichert, was ein neues Untermodell erzeugte, das Effizienz und Flexibilität zeigt.
Open Source: https://huggingface.co/tngtech/DeepSeek-TNG-R1T2-Chimera