
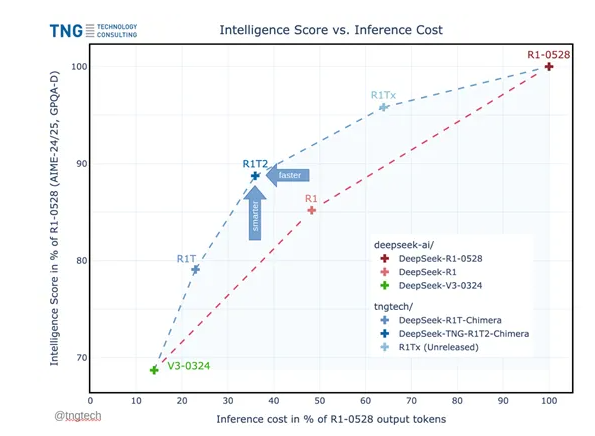
Hace unos días, la conocida empresa alemana de consultoría tecnológica TNG lanzó una versión mejorada de DeepSeek - DeepSeek-TNG-R1T2-Chimera, lo que marca otro gran avance en la eficiencia y rendimiento de los modelos de aprendizaje profundo. Esta nueva versión no solo mejora en un 200% la eficiencia de razonamiento, sino que también reduce significativamente el costo de razonamiento mediante la innovadora arquitectura AoE.
La arquitectura AoE innovadora
La versión Chimera se desarrolló mediante la combinación de tres modelos principales de DeepSeek: R1-0528, R1 y V3-0324, utilizando una nueva arquitectura AoE (Adaptive Expert). Esta arquitectura optimiza detalladamente la arquitectura MoE (Mixture of Experts), permitiendo utilizar eficientemente los parámetros del modelo, mejorando así el rendimiento del razonamiento y ahorrando tokens de salida.
En varios benchmarks principales (como MTBench y AIME-2024), la versión Chimera supera a la versión estándar R1, demostrando una capacidad de razonamiento y economía significativas.
Ventajas de la arquitectura MoE
Antes de comprender profundamente la arquitectura AoE, es necesario entender la arquitectura Mixture of Experts (MoE). La arquitectura MoE divide las capas feed-forward de Transformer en múltiples "expertos", y cada marcador de entrada solo se dirige a algunos expertos. Este método mejora efectivamente la eficiencia y el rendimiento del modelo.
Por ejemplo, el modelo Mixtral-8x7B lanzado por Mistral en 2023, aunque tiene solo 1.3 mil millones de parámetros activados, puede competir con el modelo LLaMA-2-70B de 70 mil millones de parámetros, logrando una eficiencia de razonamiento 6 veces mayor.
La arquitectura AoE aprovecha la característica de gran precisión de MoE, permitiendo a los investigadores construir submodelos con capacidades específicas a partir de modelos existentes de MoE. Al interpolar y fusionar selectivamente los tensores de peso de los modelos padres, los nuevos modelos no solo conservan las características excelentes, sino que también pueden ajustarse flexiblemente según las necesidades reales.
Los investigadores eligieron DeepSeek-V3-0324 y DeepSeek-R1 como modelos padres, y mediante diferentes técnicas de fine-tuning, ambos modelos mostraron un excelente rendimiento en términos de capacidad de razonamiento e interpretación de instrucciones.
Fusión y optimización de pesos
Al construir nuevos submodelos, los investigadores primero deben preparar los tensores de peso de los modelos padres y operar directamente sobre los archivos de peso. Luego, al definir los coeficientes de peso, los investigadores pueden interpolar y fusionar suavemente las características de los modelos padres, generando nuevas variantes del modelo.
Durante el proceso de fusión, los investigadores introdujeron mecanismos de control de umbrales y selección de diferencias, asegurando que solo se incluyan los tensores relevantes cuando haya diferencias significativas, reduciendo así la complejidad del modelo y el costo computacional.
En la arquitectura MoE, los tensores de expertos de enrutamiento son una parte crucial, ya que determinan qué módulo de experto se selecciona durante el razonamiento de las etiquetas de entrada. El método AoE presta especial atención a la fusión de estos tensores, y los investigadores descubrieron que optimizar los tensores de expertos de enrutamiento puede mejorar significativamente la capacidad de razonamiento del submodelo.
Finalmente, mediante el marco PyTorch, los investigadores lograron la fusión del modelo. Los pesos fusionados se guardaron en nuevos archivos de peso, generando un nuevo submodelo, que muestra alta eficiencia y flexibilidad.
Repositorio de código abierto: https://huggingface.co/tngtech/DeepSeek-TNG-R1T2-Chimera