
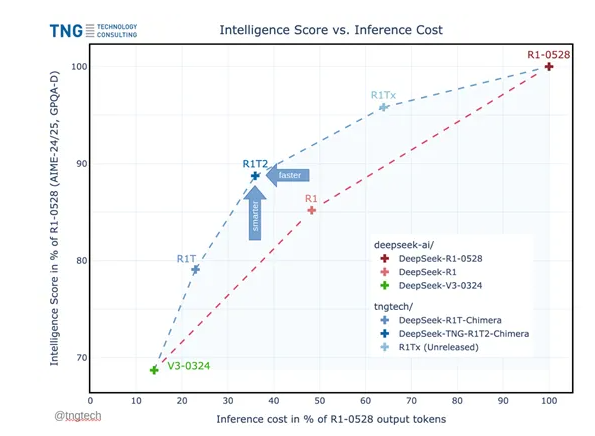
Recentemente, a empresa de consultoria técnica alemã TNG lançou uma versão aprimorada do DeepSeek — o DeepSeek-TNG-R1T2-Chimera, marcando mais um grande avanço nas capacidades de eficiência e desempenho dos modelos de aprendizado profundo. Essa nova versão não apenas aumentou em 200% a eficiência da inferência, mas também reduziu significativamente os custos de inferência por meio da inovadora arquitetura AoE.
A arquitetura inovadora AoE
A versão Chimera foi desenvolvida com base nos três modelos principais do DeepSeek: R1-0528, R1 e V3-0324, utilizando uma nova arquitetura AoE (Adaptive Expert). Essa arquitetura otimiza cuidadosamente a arquitetura MoE (Mixture of Experts), permitindo que os parâmetros do modelo sejam usados de forma eficiente, melhorando assim o desempenho da inferência e economizando tokens de saída.
Em vários benchmarks principais (como MTBench e AIME-2024), a versão Chimera superou a versão normal R1, demonstrando uma capacidade de raciocínio notável e economicidade.
Vantagens da arquitetura MoE
Antes de compreender a arquitetura AoE, é necessário entender a arquitetura MoE (Mixture of Experts). A arquitetura MoE divide as camadas feed-forward do Transformer em vários "especialistas", e cada marcação de entrada é roteada apenas para alguns especialistas. Esse método melhora eficientemente a eficiência e o desempenho do modelo.
Por exemplo, o modelo Mixtral-8x7B lançado pela Mistral em 2023 possui apenas 1,3 bilhão de parâmetros ativos, mas consegue competir com o modelo LLaMA-2-70B de 70 bilhões de parâmetros, tendo uma eficiência de inferência 6 vezes maior.
A arquitetura AoE aproveita as características granulares da MoE, permitindo que os pesquisadores construam submodelos com habilidades específicas a partir de modelos existentes de MoE. Por meio de interpolação e fusão seletiva dos tensores de pesos dos modelos pais, o novo modelo mantém suas boas características e pode ajustar flexivelmente seu desempenho de acordo com as necessidades reais.
Os pesquisadores escolheram o DeepSeek-V3-0324 e o DeepSeek-R1 como modelos pais, usando diferentes técnicas de fine-tuning, garantindo que esses dois modelos tivessem excelentes capacidades de inferência e seguir instruções.
Fusão e otimização de pesos
Durante a construção do novo submodelo, os pesquisadores primeiro precisaram preparar os tensores de pesos dos modelos pais e operá-los diretamente analisando os arquivos de pesos. Em seguida, definindo coeficientes de pesos, os pesquisadores poderiam interpolar e fundir suavemente as características dos modelos pais, gerando novas variantes do modelo.
Durante o processo de fusão, os pesquisadores introduziram mecanismos de controle de limiar e seleção de diferenças, garantindo que apenas os tensores com diferenças significativas fossem incluídos na fusão, reduzindo assim a complexidade do modelo e os custos computacionais.
Na arquitetura MoE, os tensores de especialistas de roteamento são uma parte crucial, pois determinam quais módulos de especialistas são escolhidos durante a inferência das marcas de entrada. O método AoE foca especialmente na fusão desses tensores, e os pesquisadores descobriram que otimizar os tensores de especialistas de roteamento pode melhorar significativamente a capacidade de raciocínio do submodelo.
Finalmente, por meio do framework PyTorch, os pesquisadores realizaram a fusão do modelo. Os pesos combinados foram salvos em novos arquivos de pesos, gerando um novo submodelo, que demonstrou alta eficiência e flexibilidade.
Endereço do código aberto: https://huggingface.co/tngtech/DeepSeek-TNG-R1T2-Chimera