9月15日,在济南召开的2026年国家网络安全宣传周人工智能安全治理分论坛上,中文互联网基础语料4.0正式发布并全面上线,数据总量达120GB,旨在为大模型训练和人工智能产业高质量发展提供坚实可信的数据支撑。该语料由中央网信办指导,中国网络安全协会等多家机构联合发布。
腾讯混元联合UCLA、港中文等机构,针对多模态大语言模型(MLLMs)从“被动理解”向“主动推理”进化的需求,开源了多模态搜索智能体。此前,高质量数据、自动化轨迹合成路径及训练配方的缺失,导致顶尖智能体难以复现。此次开源旨在打破僵局,推动社区发展。
国家数据局通过官方渠道将大模型计量单位“Token”正式定名为“词元”,并披露我国AI行业日均词元调用量已超140万亿次。此举统一了长期存在的译名争议,标志着大模型技术标准在国家层面进一步规范化。
国产大模型正通过提升中文数据占比(普遍超60%)来增强对本土文化和用户需求的理解,降低对英文语料的依赖,使AI能更精准解析“上火”等特有概念,推动技术革新。
免费中文印度占星排盘与AI解读,恒星黄道整宫制,出生数据仅存本地。
多模型AI驱动的2026世界杯及足球赛事比分预测与中文资料数据库。
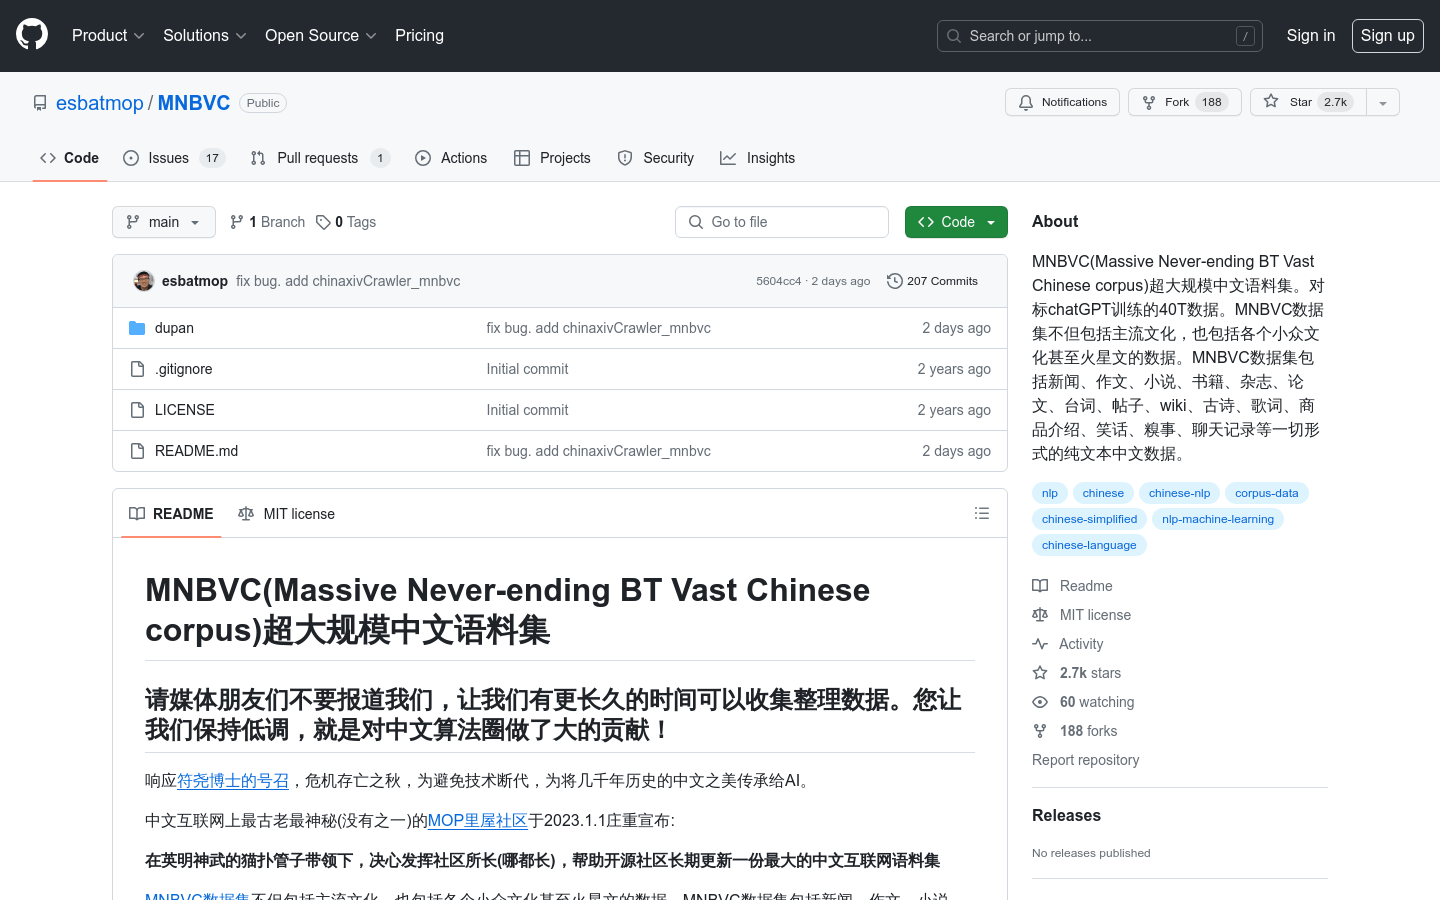
MNBVC是一个超大规模的中文语料集,对标chatGPT训练的40T数据
Openai
-
Input tokens/M
Output tokens/M
Context Length
Anthropic
$105
$525
200
$21
Google
$0.7
$2.8
1k
Alibaba
$6
$24
256
$8
$240
52
Moonshot
$4
$16
Baidu
32
$2
$8.75
$70
400
$1.75
$14
$0.35
Tencent
24
$2.4
$12
8
Xai
ai-sage
GigaChat3-10B-A1.8B 是 GigaChat 系列的高效对话模型,基于混合专家(MoE)架构,拥有 100 亿总参数和 18 亿活跃参数。它采用了创新的多头潜在注意力(MLA)和多令牌预测(MTP)技术,旨在优化推理吞吐量和生成速度。模型在 20T 令牌的多样化数据上训练,支持包括中文在内的 10 种语言,适用于需要快速响应的对话场景。
winninghealth
WiNGPT-Babel-2 是一款专为多语言翻译任务优化的语言模型,支持55种语言的翻译,特别优化了中文翻译和结构化数据处理能力。
wsqstar
基于bert-base-chinese在微博100k情感分析数据集上微调的中文文本分类模型
hexgrad
Kokoro 是一个开放权重的小型但功能强大的文本转语音(TTS)模型系列,新增了来自专业数据集的100名中文说话人数据。
llm-jp
LLM-jp-3-440m是由日本国立情报学研究所大语言模型研发中心开发的日语大语言模型系列中的440M参数版本。该模型基于Transformer架构,支持日语、英语、中文、韩语等多种语言,并在大规模多语言数据集上进行预训练。
tencent
混元7B是腾讯开源的中英文双语大语言模型,采用更优的数据配比和训练方式,性能强劲,是目前最强的中文7B Dense模型之一。
openbmb
该模型在多个中文和英文数据集上进行了测试,包括语义文本相似度和分类任务。
Macropodus
macbert4csc_v2是一款用于中文拼写纠错的模型,采用了特定架构和训练策略,在多个测评数据集上表现良好,适用于多种领域的文本纠错任务。
aisingapore
Llama-SEA-LION-v3-70B-IT是一款多语言大语言模型,专门针对东南亚语言进行了优化。该模型在约1230万条英语指令-完成对和450万条东南亚语言指令-完成对的数据集上进行了两阶段微调,支持包括缅甸语、中文、英语、菲律宾语、印尼语等13种语言。
real-jiakai
该模型是在中文版SQuAD v2.0数据集上对bert-base-chinese进行微调的版本,专为中文问答任务设计,支持可回答与不可回答问题。
PassbyGrocer
基于BERT-BiLSTM-CRF架构的中文命名实体识别模型,在微博数据集上微调,适用于社交媒体文本的实体识别任务
jethrowang
基于OpenAI Whisper Tiny模型在Common Voice 11.0中文数据集上微调的语音识别模型
stephenlzc
这是一个基于Dolphin-2.9-Llama3-8B进行中文微调的语言模型,使用多个中文数据集进行训练,支持中文和英文的文本生成和对话任务。
listenrwt
基于llama3-8b微调的中文轻小说生成模型,使用40,000组小说上下文数据训练
hfl
Llama-3-Chinese-8B-Instruct是基于Llama-3-Chinese-8B模型,使用500万条指令数据进一步微调得到的对话模型,专门针对中文场景优化,可用于对话、问答等应用。
yzhuang
基于google/gemma-1.1-7b-it在generator数据集上微调的中文语言模型
cgato
基于多种数据集训练的对话模型,支持中文交互,适用于非商业场景
IDEA-CCNL
Taiyi-Diffusion-XL是一个专注于增强中文文生图生成能力的同时保留英文理解能力的双语扩散模型。基于Stable-Diffusion-XL架构,通过高质量双语数据集训练,在图像质量、多样性和文本对齐方面表现出色,为AIGC和数字艺术创作提供新的选择。
Locutusque
基于微软Orca-2-13b模型微调的多语言大语言模型,支持英语、法语、西班牙语、印地语和中文,在多个数据集上进行了全面微调,测试损失达到0.18。
Amu
tao-8k-origin 是一个专注于句子相似度计算的模型,支持多种相似度度量方式,并在多个中文评测数据集上表现出色。
Pulse CN MCP Server是一个实时获取中国互联网热门内容的MCP协议服务器,支持微博、今日头条等18个平台的热搜数据,为AI模型提供最新中文趋势信息。
一个基于MCP协议的服务端,提供与万智牌中文卡牌数据库的交互功能,包括卡牌查询、系列获取和活字乱刷等特色功能。
 GgufMultiple Languages
%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23061b40;%20}%20.st1%20{%20fill:%20%23306af1;%20}%20.st2%20{%20fill:%20%235ce5cf;%20}%20%3c/style%3e%3c/defs%3e%3cg%3e%3cpath%20class='st0'%20d='M55,10.5h9v3h-9v9h12V7.5h-12v3ZM64,19.5h-6v-3h6v3Z'/%3e%3cpolygon%20class='st0'%20points='69%2016.5%2078%2016.5%2078%2019.5%2069%2019.5%2069%2022.5%2081%2022.5%2081%2013.5%2072%2013.5%2072%2010.5%2081%2010.5%2081%207.5%2069%207.5%2069%2016.5'/%3e%3cpolygon%20class='st0'%20points='95%2010.5%2095%207.5%2083%207.5%2083%2022.5%2095%2022.5%2095%2019.5%2086%2019.5%2086%2016.5%2095%2016.5%2095%2013.5%2086%2013.5%2086%2010.5%2095%2010.5'/%3e%3cpath%20class='st0'%20d='M40,1.5v21h11.6l1.4-1.4v-7.6h0c0,0-1.4-1.5-1.4-1.5l1.4-1.4V2.9l-1.4-1.4h-11.6ZM50,19.5h-7v-6h7v6ZM50,10.5h-7v-6h7v6Z'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M23.1,24L14.7,4.8l-4.9,11.2h3.8l-1.8,4H3.3L12.1,0H2C.9,0,0,.9,0,2v20c0,1.1.9,2,2,2h21.1Z'/%3e%3cpath%20class='st2'%20d='M34,0h-16.8l10.6,24h6.2c1.1,0,2-.9,2-2V2C36,.9,35.1,0,34,0ZM32.5,20h-4V4h4v16Z'/%3e%3c/svg%3e)
 Join Now