科大讯飞9月23日发布新一代语音识别大模型Spark-ASR-2.0,标志语音交互与智能硬件落地关键升级。该模型9月24日起在讯飞输入法逐步上线,并通过开放平台向开发者及企业提供API服务,后续还将落地讯飞AI眼镜、智能办公本等设备。
科大讯飞发布语音基座大模型Spark-Audio-1.0-Preview,基于全国产算力训练,降低供应链风险。模型支持文本和语音输入、文本输出,具备语音转写、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析及音频问答等能力。
科大讯飞上线语音基座大模型Spark-Audio-1.0-Preview,基于全国产化算力训练。传统音频处理多采用级联方案,先转文字再理解,存在信息丢失(忽略语气、情绪、背景环境音)和链路割裂(语音转写、声纹识别等环节分离)两大短板,影响场景判断完整性。
科大讯飞发布星火X2.5大模型,采用混合专家架构,总参数2930亿、推理仅激活300亿,兼顾高效与性能提升。重点强化代码生成和智能体交互,数学计算、语义理解等通用能力增强,并全面支持256K长上下文处理。
科大讯飞新一代全场景AI生产力工作台,输入目标即可交付多类型成果
讯飞绘镜:AI短视频创作平台,4步生成视频,适配多样场景
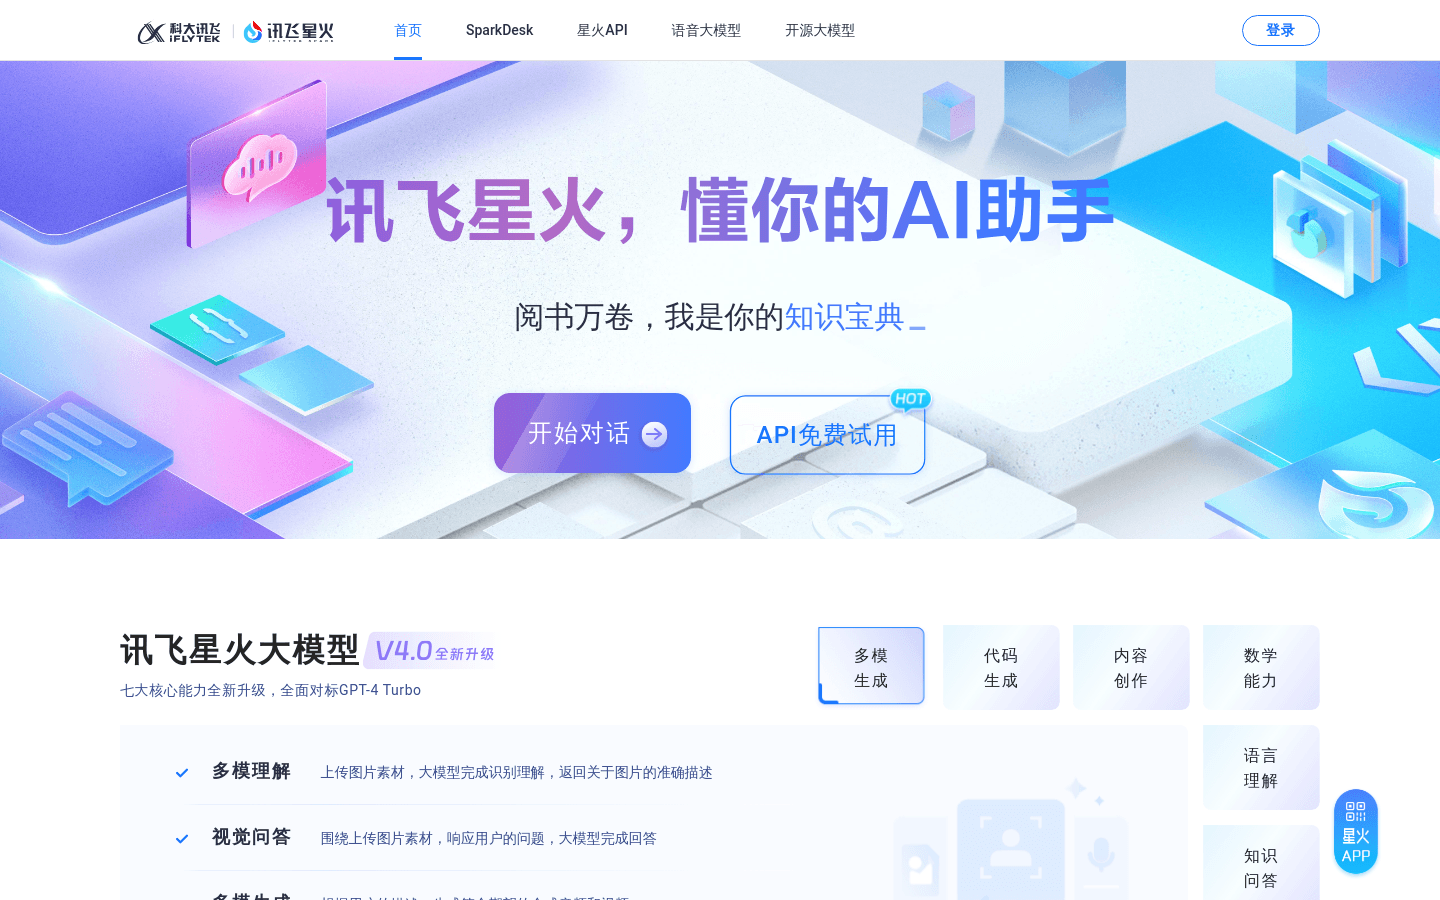
全面对标GPT-4 Turbo的AI大语言模型
全栈式虚拟人多场景应用服务
Iflytek
$2
Input tokens/M
-
Output tokens/M
Context Length
8
$8
Baidu
hfl
中文ELECTRA是由哈工大-讯飞联合实验室基于谷歌ELECTRA模型开发的中文预训练模型,具有参数量小但性能优越的特点。
这是一个采用全词掩码技术的中文预训练BERT模型,由哈工大讯飞联合实验室开发,旨在加速中文自然语言处理的发展。
这是一个采用全词掩码策略的中文预训练BERT模型,由哈工大讯飞联合实验室发布,旨在加速中文自然语言处理研究。
中文ELECTRA是哈工大-讯飞联合实验室基于谷歌ELECTRA架构开发的中文预训练模型,参数量仅为BERT的1/10但性能相近。
中文ELECTRA是哈工大-讯飞联合实验室基于谷歌ELECTRA模型发布的中文预训练模型,体积小且性能优越。
中文ELECTRA是由哈工大-讯飞联合实验室(HFL)基于谷歌与斯坦福大学发布的ELECTRA模型开发的中文预训练模型,具有参数量小、性能高的特点。
中文ELECTRA是基于谷歌ELECTRA模型的中文预训练模型,由哈工大与讯飞联合实验室发布,具有结构紧凑、性能优越的特点。
一个使用MCP服务器调用讯飞星火Agent平台任务链的示例项目
%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23061b40;%20}%20.st1%20{%20fill:%20%23306af1;%20}%20.st2%20{%20fill:%20%235ce5cf;%20}%20%3c/style%3e%3c/defs%3e%3cg%3e%3cpath%20class='st0'%20d='M55,10.5h9v3h-9v9h12V7.5h-12v3ZM64,19.5h-6v-3h6v3Z'/%3e%3cpolygon%20class='st0'%20points='69%2016.5%2078%2016.5%2078%2019.5%2069%2019.5%2069%2022.5%2081%2022.5%2081%2013.5%2072%2013.5%2072%2010.5%2081%2010.5%2081%207.5%2069%207.5%2069%2016.5'/%3e%3cpolygon%20class='st0'%20points='95%2010.5%2095%207.5%2083%207.5%2083%2022.5%2095%2022.5%2095%2019.5%2086%2019.5%2086%2016.5%2095%2016.5%2095%2013.5%2086%2013.5%2086%2010.5%2095%2010.5'/%3e%3cpath%20class='st0'%20d='M40,1.5v21h11.6l1.4-1.4v-7.6h0c0,0-1.4-1.5-1.4-1.5l1.4-1.4V2.9l-1.4-1.4h-11.6ZM50,19.5h-7v-6h7v6ZM50,10.5h-7v-6h7v6Z'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M23.1,24L14.7,4.8l-4.9,11.2h3.8l-1.8,4H3.3L12.1,0H2C.9,0,0,.9,0,2v20c0,1.1.9,2,2,2h21.1Z'/%3e%3cpath%20class='st2'%20d='M34,0h-16.8l10.6,24h6.2c1.1,0,2-.9,2-2V2C36,.9,35.1,0,34,0ZM32.5,20h-4V4h4v16Z'/%3e%3c/svg%3e)
 Join Now