10月13日,千问发布AI眼镜N1、N1Pro及与Bose合作的AI耳夹式耳机,标志AI个人智能体向物理世界延伸。N1系列搭载5000万像素影像、1G5P镜头和端侧视觉模型,支持环境感知、翻译、纪要与语音办事;N1Pro为首款支持心率、血氧、皮肤温度监测的AI眼镜,并引入眼动交互与超低误识率虹膜识别。
9月27日,英伟达发布约1亿参数免费AI模型Nemotron3Diarization,专注语音分割聚类。其开放权重,可精准识别任意时刻说话者,支持最多8人同时发声的实时与录音处理。在VoiceArena v1基准测试中,它以14.72%错误率登顶,显著优于第二名。
科大讯飞9月23日发布新一代语音识别大模型Spark-ASR-2.0,标志语音交互与智能硬件落地关键升级。该模型9月24日起在讯飞输入法逐步上线,并通过开放平台向开发者及企业提供API服务,后续还将落地讯飞AI眼镜、智能办公本等设备。
千问发布Qwen-Audio-3.1系列语音大模型,全面升级语音识别、合成与实时交互,并推出音频创作模型TTS-Next与理解模型ASR-Next,五款模型覆盖“理解—生成—交互—创作”完整能力栈。同时全线降价,TTS降约70%,降低使用门槛。
开源的前沿语音 AI 模型,支持语音识别和文本转语音。
先进的文本转语音模型,提供高质量的语音合成服务。
一款支持中英文的对话语音合成模型。
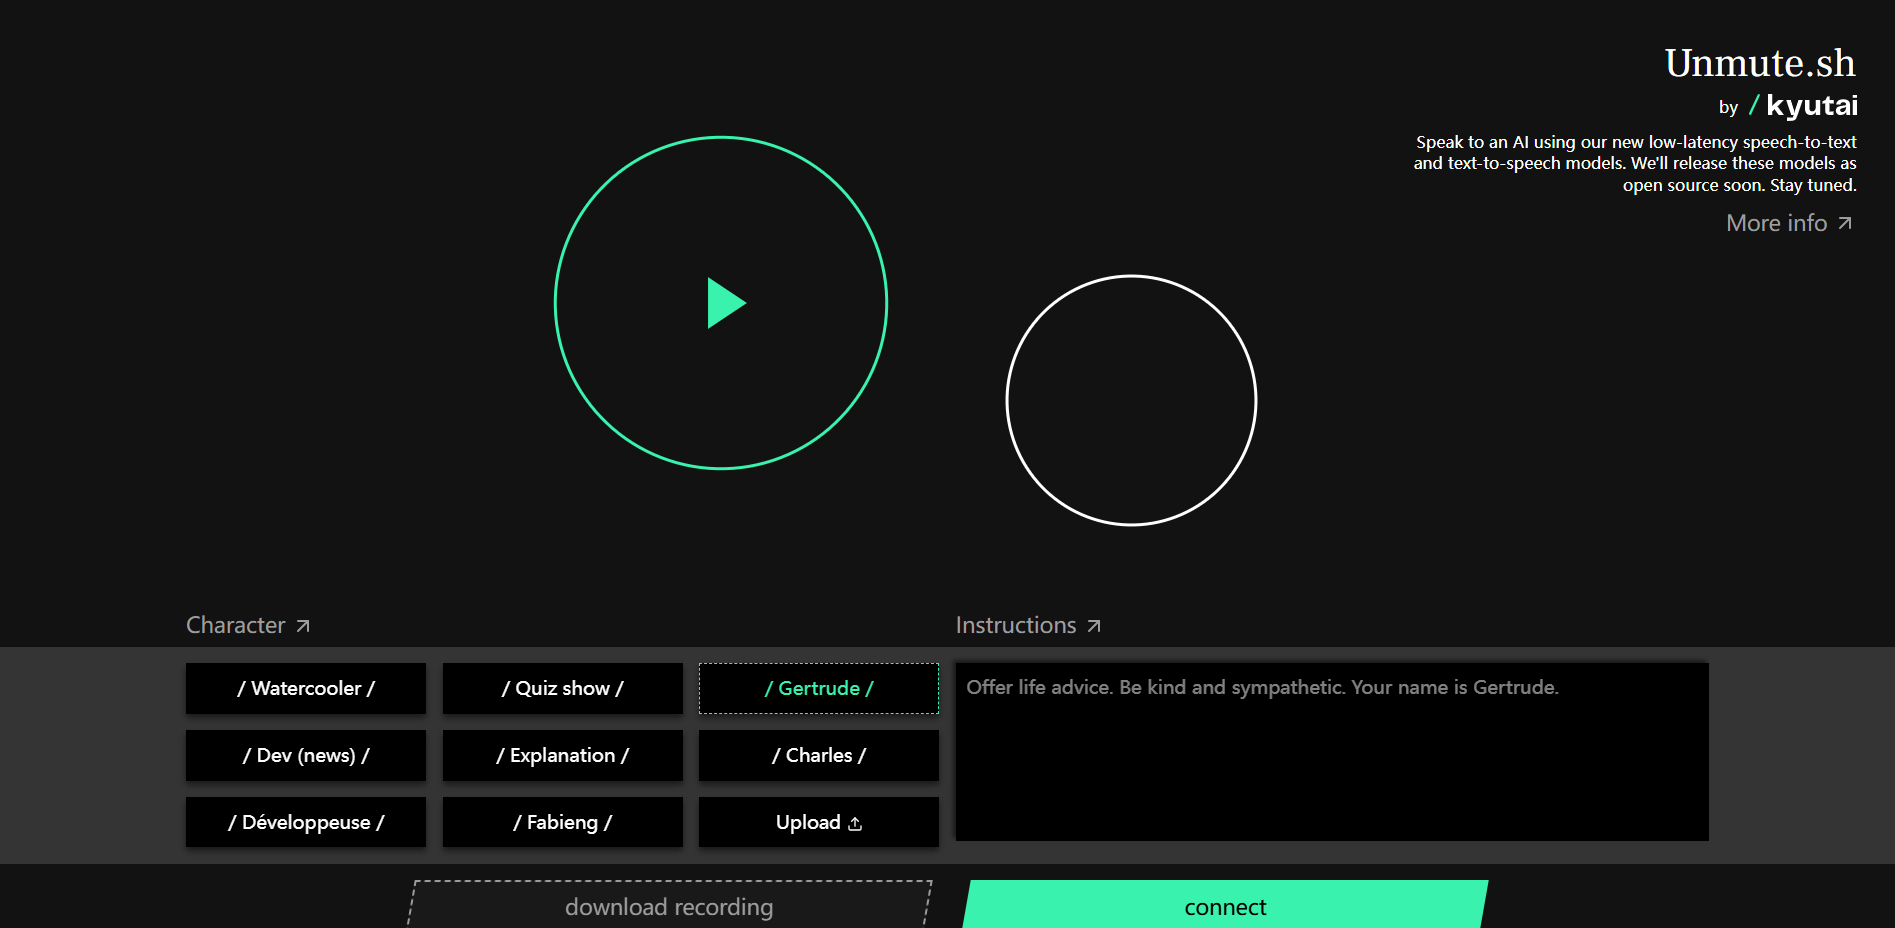
使用低延迟语音识别和合成模型与 AI 对话。
Openai
$2.8
Input tokens/M
$11.2
Output tokens/M
1k
Context Length
Google
$0.49
$2.1
Xai
$1.4
$3.5
2k
$7.7
$30.8
200
-
Anthropic
$105
$525
$0.7
$7
$35
$17.5
$21
Alibaba
$4
$16
$1
$10
256
$2
$20
$6
$24
Baidu
128
$8
$240
52
Bytedance
$1.2
$3.6
4
kyr0
这是一个专为苹果硅芯片设备优化的自动语音识别模型,通过转换为MLX框架并量化为FP8格式,实现在苹果设备上的快速端上语音转录。该模型针对逐字精度进行微调,特别适用于需要高精度转录的场景。
ai-sage
GigaAM-v3是基于Conformer架构的俄语自动语音识别基础模型,拥有2.2-2.4亿参数。它是GigaAM系列的第三代模型,在70万小时俄语语音数据上使用HuBERT-CTC目标进行预训练,在广泛的俄语ASR领域提供最先进的性能。
abr-ai
这是一个由Applied Brain Research(ABR)开发的基于状态空间模型(SSM)的英文自动语音识别模型,拥有约1900万参数,能够高效准确地将英文语音转录为文本。该模型在多个基准数据集上表现出色,平均单词错误率仅为10.61%,支持实时语音识别并可在低成本硬件上运行。
ycngin2024
这是一个经过微调的Whisper语音识别模型,基于unsloth/whisper-large-v3-turbo架构,使用Unsloth和Huggingface TRL库实现了2倍训练加速,显著提升了训练效率。
adoamesh
本模型是基于OpenAI Whisper-small模型针对斯瓦希里语进行微调的自动语音识别模型。在FLEURS-SLU数据集的斯瓦希里语部分进行训练,显著提升了斯瓦希里语的转录准确率,单词错误率相比基础模型降低了68%。
thenexthub
这是一个支持多语言处理的多模态模型,涵盖自然语言处理、代码处理、音频处理等多个领域,能够实现自动语音识别、语音摘要、语音翻译、视觉问答等多种任务。
MERaLiON
MERaLiON-SER-v1 是一个参数高效的多语言语音情感识别模型,能够同时预测7种离散情感类别和连续的情感维度值。该模型基于Whisper-Medium编码器构建,采用LoRA自适应技术,在多语言语音情感识别任务中表现出色。
teckedd
本模型是基于OpenAI Whisper-small在Common Voice 17.0数据集上微调的自动语音识别模型,专门针对Twi语言进行优化,能够实现语音内容的准确识别。
inclusionAI
Ming-flash-omni 预览版是基于 Ling-Flash-2.0 稀疏专家混合(MoE)架构构建的多模态大模型,总参数达100B,每个token仅激活6B参数。该模型在Ming-Omni基础上进行了全面升级,在多模态理解和生成方面有显著提升,特别是在语音识别、图像生成和分割编辑方面表现突出。
kalilouisangare
这是一个基于 OpenAI Whisper Small 模型微调的班巴拉语语音识别模型,在 24738 个班巴拉语音频样本上训练,能够将班巴拉语语音准确转录为文本,字符错误率低至 21.69%。
Ken-Z
本模型是基于OpenAI Whisper-small在拉丁语上微调的自动语音识别模型,使用67小时拉丁语音频数据训练,字符错误率(CER)为20,支持拉丁语语音转文本任务。
ReportAId
MedWhisper Large ITA是基于OpenAI Whisper Large v3 Turbo的领域适配变体,专门针对意大利语医疗语音识别进行了优化。该模型在精心挑选的意大利语门诊专科就诊录音集上使用LoRA技术进行微调,显著提升了医学术语和临床表达的识别准确率。
eustlb
这是一个基于Hugging Face Transformers库的自动语音识别模型,能够将音频内容转换为文本。该模型支持多种语言,适用于实时语音转文字、音频转录等场景。
Vikhrmodels
Borealis 是首款面向俄语的自动语音识别(ASR)音频大语言模型,经过约7000小时俄语音频数据训练。该模型支持识别音频中的标点符号,架构受Voxtral启发但有所改进,在多个俄语ASR基准测试中表现优异。
feelmadrain
这是一个基于OpenAI Whisper Small架构的俄语自动语音识别模型,在Common Voice 17.0数据集上进行了专门训练,能够准确地将俄语语音转换为文本。
openchs
基于OpenAI Whisper Large v2在Common Voice 17.0斯瓦希里语数据集上微调的语音识别模型,专为坦桑尼亚儿童求助热线的斯瓦希里语语音识别任务设计,相比基础模型在斯瓦希里语识别准确率上有显著提升。
BUT-FIT
SE-DiCoW是由BUT Speech@FIT联合JHU CLSP/HLTCOE和CMU LTI开发的目标说话人多说话人自动语音识别模型。该模型基于Whisper large-v3-turbo,通过自注册机制和改进的数据增强技术,在高度重叠的多说话人场景下显著提升了识别准确率。
UsefulSensors
Moonshine Tiny是由Moonshine AI(原有用传感器公司)开发的轻量级越南语自动语音识别模型,仅有27M参数,专为资源受限平台设计,在Fleurs和Common Voice 17数据集上表现出色。
jacktol
基于OpenAI Whisper Large v3模型微调的航空交通管制语音识别模型,专门针对ATC通信场景优化,在测试集上实现了6.5%的字错误率,显著提升了航空通信转录的准确性。
FluidInference
parakeet-tdt-0.6b-v3 是一款强大的多语言自动语音识别模型,支持英语、西班牙语、法语、德语等多种欧洲语言,基于FastConformer-TDT架构,使用公开数据集训练,为跨语言语音识别提供高效解决方案。
基于Faster Whisper的高性能语音识别MCP服务器,提供高效的音频转写能力,支持批量处理、多模型尺寸和多种输出格式。
该项目扩展了视频语音识别功能,从仅支持本地Whisper模型,新增支持简影和B站剪辑的在线语音识别服务,提供了灵活的多服务选择架构。
%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23061b40;%20}%20.st1%20{%20fill:%20%23306af1;%20}%20.st2%20{%20fill:%20%235ce5cf;%20}%20%3c/style%3e%3c/defs%3e%3cg%3e%3cpath%20class='st0'%20d='M55,10.5h9v3h-9v9h12V7.5h-12v3ZM64,19.5h-6v-3h6v3Z'/%3e%3cpolygon%20class='st0'%20points='69%2016.5%2078%2016.5%2078%2019.5%2069%2019.5%2069%2022.5%2081%2022.5%2081%2013.5%2072%2013.5%2072%2010.5%2081%2010.5%2081%207.5%2069%207.5%2069%2016.5'/%3e%3cpolygon%20class='st0'%20points='95%2010.5%2095%207.5%2083%207.5%2083%2022.5%2095%2022.5%2095%2019.5%2086%2019.5%2086%2016.5%2095%2016.5%2095%2013.5%2086%2013.5%2086%2010.5%2095%2010.5'/%3e%3cpath%20class='st0'%20d='M40,1.5v21h11.6l1.4-1.4v-7.6h0c0,0-1.4-1.5-1.4-1.5l1.4-1.4V2.9l-1.4-1.4h-11.6ZM50,19.5h-7v-6h7v6ZM50,10.5h-7v-6h7v6Z'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M23.1,24L14.7,4.8l-4.9,11.2h3.8l-1.8,4H3.3L12.1,0H2C.9,0,0,.9,0,2v20c0,1.1.9,2,2,2h21.1Z'/%3e%3cpath%20class='st2'%20d='M34,0h-16.8l10.6,24h6.2c1.1,0,2-.9,2-2V2C36,.9,35.1,0,34,0ZM32.5,20h-4V4h4v16Z'/%3e%3c/svg%3e)
 Join Now