階躍星辰正式發佈並開源Step5Preview模型權重,面向全球開發者公開BF16與FP8權重、技術博客及配套開源開發工具。該模型此前在OpenRouter周榜、日榜調用量排名中一度穩居全球第二。架構上,它專爲長程複雜智能體任務深度優化,採用稀疏MoE架構,總參數量高達600B。
阿里雲上線靈駿真武M890超節點實例,首批在烏蘭察布開售。企業無需自建機房,即可雲端開通64卡高速互聯算力單元,支持最高十萬億參數級MoE大模型推理。該實例是國內首個成功運行超2萬億參數模型的超節點算力,Kimi K3與Qwen3.8Max已基於其提供服務,內置FP8/FP4低精度計算,並採用ICN Switch1.0芯片。
螞蟻集團百靈大模型今日開源Ling-2.6-flash,推出BF16、FP8、INT4等多量化版本,降低AI部署門檻。該模型總參數104B,激活參數7.4B,此前以匿名身份在國際評測平臺表現優異,並針對中英文切換與代碼生成完成多輪優化。
螞蟻集團百靈大模型系列更新,Ling-2.6-flash正式開放。該模型總參數104B,激活參數7.4B,提供BF16、FP8、INT4等多精度版本,適配不同硬件環境並降低部署門檻。此前以“Elephant Alpha”匿名在OpenRouter平臺測試。
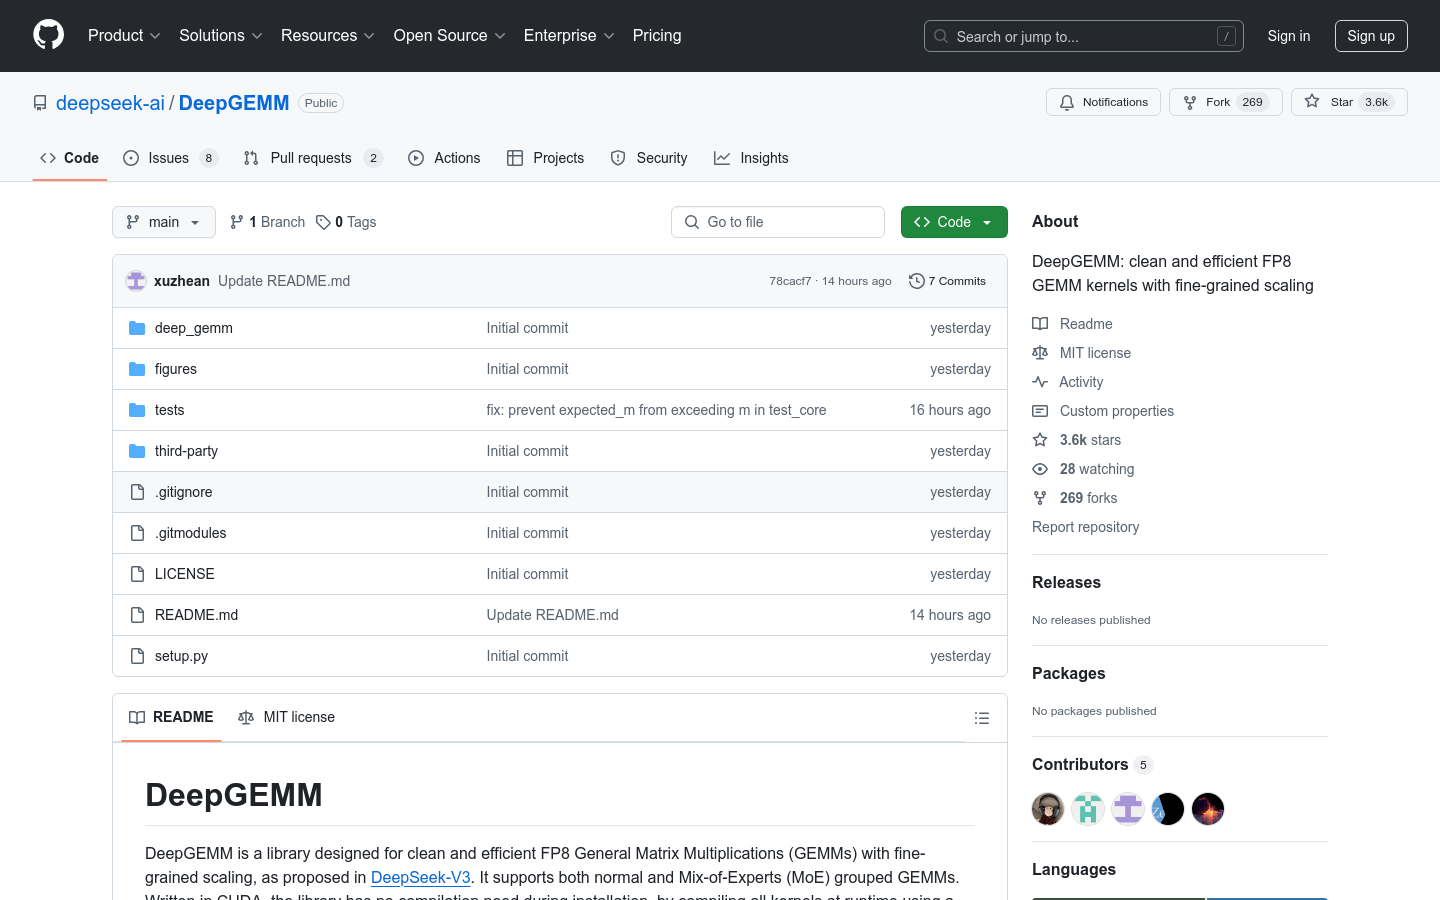
DeepGEMM是一個用於高效FP8矩陣乘法的CUDA庫,支持細粒度縮放和多種優化技術。
Alibaba
-
輸入tokens/百萬
輸出tokens/百萬
上下文長度
Tencent
$6
$18
256
Chatglm
128
T5B
Z-Image-Turbo 是經過 FP8 E5M2 和 E4M3FN 格式量化的圖像處理模型,基於原始 Tongyi-MAI/Z-Image-Turbo 模型優化,在保持性能的同時顯著減少模型大小和推理資源需求。
silveroxides
基於 black-forest-labs/FLUX.2-dev 的優化版本圖像生成模型,支持圖像到圖像的生成和編輯任務,採用 fp8_scaled 量化技術提升推理速度,特別適合在低顯存 GPU 上使用。
kyr0
這是一個專為蘋果硅芯片設備優化的自動語音識別模型,通過轉換為MLX框架並量化為FP8格式,實現在蘋果設備上的快速端上語音轉錄。該模型針對逐字精度進行微調,特別適用於需要高精度轉錄的場景。
mratsim
GLM-4.5-Iceblink-v2-106B-A12B-FP8是基於GLM-4.5-Iceblink-v2-106B-A12B模型,採用最先進的混合專家量化方法進行FP8量化的版本。該模型專門針對支持硬件FP8的Ada、Hopper或Blackwell系列GPU優化,在保持高質量輸出的同時顯著提升推理效率。
Qwen
Qwen3-VL-2B-Instruct-FP8是Qwen系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度fp8量化,性能與原始BF16模型幾乎相同。該模型具備卓越的文本理解和生成能力、深入的視覺感知與推理能力、長上下文支持以及增強的空間和視頻動態理解能力。
Qwen3-VL-32B-Instruct-FP8是Qwen系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度fp8量化,性能指標與原始BF16模型幾乎相同。該模型具備卓越的文本理解與生成能力、深入的視覺感知與推理能力、長上下文支持以及強大的空間和視頻動態理解能力。
Qwen3-VL-32B-Thinking-FP8是Qwen系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度fp8量化技術,性能指標與原始BF16模型幾乎相同。該模型具備出色的文本理解與生成能力、深入的視覺感知與推理能力、長上下文支持以及強大的智能體交互能力。
RedHatAI
這是Meta Llama-3.1-8B-Instruct模型的FP8量化版本,通過對權重和激活值進行FP8量化,顯著減少了磁盤大小和GPU內存需求,同時保持了良好的模型性能。
allenai
olmOCR-2-7B-1025的FP8量化版本,基於Qwen2.5-VL-7B-Instruct微調而來,專門用於處理數學方程、表格等複雜OCR場景的視覺語言模型。
Qwen3-VL-30B-A3B-Thinking-FP8是通義系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度fp8量化,性能指標與原始BF16模型幾乎相同。該模型具備卓越的文本理解與生成能力、深入的視覺感知與推理能力,支持長上下文和視頻理解。
Qwen3-VL-30B-A3B-Instruct-FP8是通義系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度FP8量化,性能與原始BF16模型幾乎相同。該模型具備卓越的文本理解和生成能力、深入的視覺感知和推理能力、長上下文支持以及強大的智能體交互能力。
Qwen3-VL-235B-A22B-Thinking-FP8是通義系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度fp8量化,性能指標與原始BF16模型幾乎相同。該模型具備卓越的文本理解與生成能力、深入的視覺感知與推理能力、長上下文支持以及強大的智能體交互能力。
Qwen3-VL-235B-A22B-Instruct-FP8是通義系列中最強大的視覺語言模型的FP8量化版本,採用塊大小為128的細粒度fp8量化,性能與原始BF16模型幾乎相同。該模型具備卓越的文本理解與生成能力、深入的視覺感知與推理能力、長上下文支持以及強大的空間和視頻動態理解能力。
ibm-granite
Granite 4.0 H-Small (FP8) 是IBM開發的Granite系列語言模型的小型FP8量化版本,專為提供專業、準確和安全的回覆而設計。該模型採用FP8精度格式,在保持性能的同時優化了推理效率。
這是NVIDIA-Nemotron-Nano-9B-v2模型的FP8動態量化版本,通過將權重和激活量化為FP8數據類型實現優化,顯著減少磁盤大小和GPU內存需求約50%,同時保持出色的文本生成性能。
這是Qwen3-VL-235B-A22B-Instruct的量化版本,通過將權重和激活值量化為FP8數據類型,有效減少了磁盤大小和GPU內存需求約50%。支持文本、圖像和視頻輸入,輸出文本,適用於多種自然語言處理和多模態任務。
Qwen3-VL-235B-A22B-Instruct-FP8-dynamic 是 Qwen3-VL-235B-A22B-Instruct 的量化版本,通過將權重和激活量化為 FP8 數據類型,顯著減少了磁盤大小和 GPU 內存需求,同時保持了較高的模型性能。
TheClusterDev
這是Qwen3-Next-80B-A3B-Instruct模型的FP8量化版本,通過vLLM框架支持,在保持模型質量的同時顯著減小了模型體積,提升了推理效率。
nvidia
這是NVIDIA對阿里巴巴Qwen3-14B模型進行FP8量化後的版本,採用優化的Transformer架構,支持131K上下文長度,適用於多種AI應用場景。
NVIDIA Qwen3-8B FP8 是阿里巴巴Qwen3-8B模型的量化版本,採用優化的Transformer架構,屬於自迴歸語言模型。該模型通過FP8量化技術優化,可在NVIDIA GPU上實現高效推理,支持商業和非商業用途。
%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23061b40;%20}%20.st1%20{%20fill:%20%23306af1;%20}%20.st2%20{%20fill:%20%235ce5cf;%20}%20%3c/style%3e%3c/defs%3e%3cg%3e%3cpath%20class='st0'%20d='M55,10.5h9v3h-9v9h12V7.5h-12v3ZM64,19.5h-6v-3h6v3Z'/%3e%3cpolygon%20class='st0'%20points='69%2016.5%2078%2016.5%2078%2019.5%2069%2019.5%2069%2022.5%2081%2022.5%2081%2013.5%2072%2013.5%2072%2010.5%2081%2010.5%2081%207.5%2069%207.5%2069%2016.5'/%3e%3cpolygon%20class='st0'%20points='95%2010.5%2095%207.5%2083%207.5%2083%2022.5%2095%2022.5%2095%2019.5%2086%2019.5%2086%2016.5%2095%2016.5%2095%2013.5%2086%2013.5%2086%2010.5%2095%2010.5'/%3e%3cpath%20class='st0'%20d='M40,1.5v21h11.6l1.4-1.4v-7.6h0c0,0-1.4-1.5-1.4-1.5l1.4-1.4V2.9l-1.4-1.4h-11.6ZM50,19.5h-7v-6h7v6ZM50,10.5h-7v-6h7v6Z'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M23.1,24L14.7,4.8l-4.9,11.2h3.8l-1.8,4H3.3L12.1,0H2C.9,0,0,.9,0,2v20c0,1.1.9,2,2,2h21.1Z'/%3e%3cpath%20class='st2'%20d='M34,0h-16.8l10.6,24h6.2c1.1,0,2-.9,2-2V2C36,.9,35.1,0,34,0ZM32.5,20h-4V4h4v16Z'/%3e%3c/svg%3e)
 VIP會員