
A rápida evolução dos grandes modelos de linguagem (LLM) nos últimos anos impulsionou os limites da tecnologia de inteligência artificial, especialmente no campo do código aberto, onde inovações nas arquiteturas de modelos tornaram-se o foco da indústria. A AIbase compilou informações recentes da internet e analisou profundamente as características e diferenças técnicas dos principais modelos de código aberto como Llama3.2, Qwen3-4B, SmolLM3-3B, DeepSeek-V3, Qwen3-235B-A22B e Kimi-K2, apresentando assim as tendências mais recentes na área de LLM para 2025.
O surgimento da arquitetura MoE: a competição entre DeepSeek-V3 e Qwen3
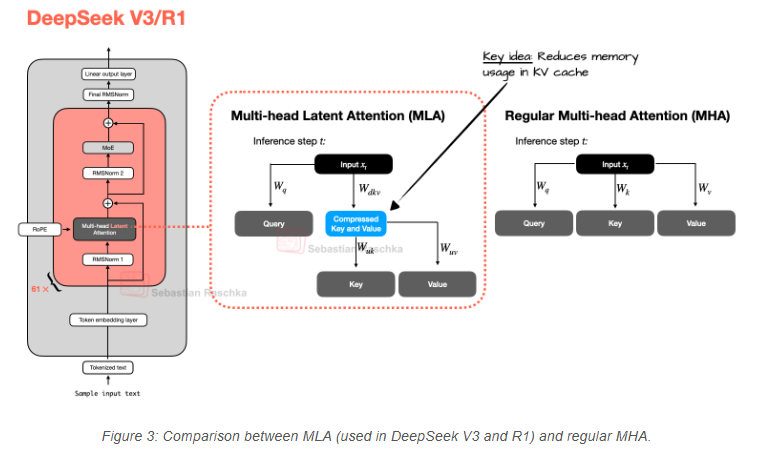
No campo dos grandes modelos de código aberto em 2025, o modelo de especialistas mistos (MoE) se tornou um foco de inovação técnica. O DeepSeek-V3 chama atenção com sua arquitetura MoE que possui 671 bilhões de parâmetros totais e 37 bilhões de parâmetros ativos. Sua característica principal é utilizar camadas MoE em cada camada Transformer (exceto as três primeiras), contando com 9 especialistas ativos (cada especialista possui uma camada oculta de tamanho 2048) e mantendo especialistas compartilhados para melhorar a estabilidade do treinamento. Em comparação, o Qwen3-235B-A22B também adota uma arquitetura MoE, com 235 bilhões de parâmetros totais e 22 bilhões de parâmetros ativos, mas escolheu abandonar os especialistas compartilhados, optando por 8 especialistas (um aumento significativo em relação aos 2 especialistas do Qwen2.5-MoE). A AIbase observou que a equipe Qwen3 não divulgou publicamente as razões para abandonar os especialistas compartilhados, mas suspeita que isso pode ser porque, com a configuração de 8 especialistas, a estabilidade do treinamento já é suficiente, sem necessidade de custos adicionais de cálculo.
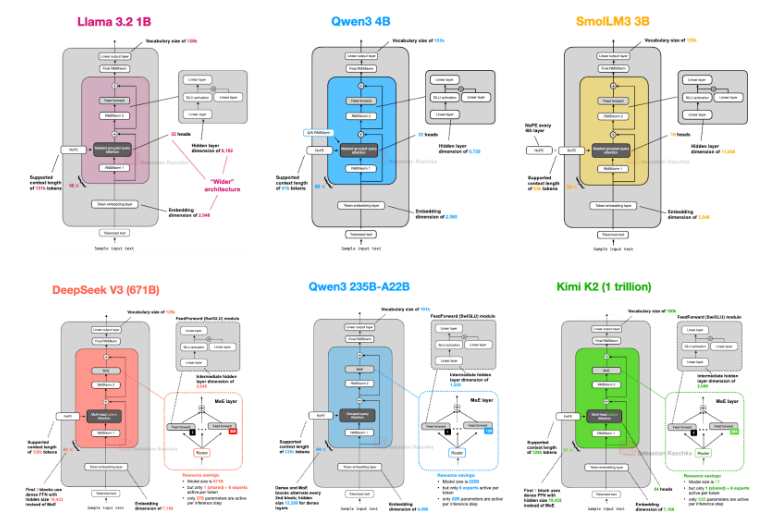
As arquiteturas do DeepSeek-V3 e do Qwen3-235B-A22B são muito semelhantes, mas pequenas diferenças revelam considerações diferentes das equipes de desenvolvimento sobre o equilíbrio entre desempenho e eficiência. Por exemplo, o DeepSeek-V3 demonstra excelente velocidade de inferência (cerca de 50 tokens/s), enquanto o Qwen3 se destaca na estruturação de saída, especialmente nas tarefas de codificação e matemática. Isso indica que a flexibilidade da arquitetura MoE oferece aos desenvolvedores espaço para otimizar os modelos de acordo com as necessidades das tarefas.
Avanços nos modelos médios e pequenos: SmolLM3-3B e Qwen3-4B
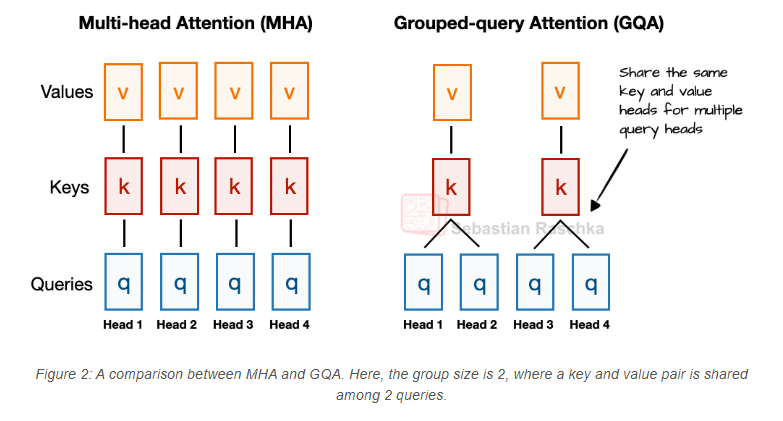
No campo dos modelos médios e pequenos, o SmolLM3-3B e o Qwen3-4B chamam atenção por sua eficiência. O SmolLM3-3B adota uma arquitetura Transformer decodificadora, equipado com atenção de consulta agrupada (GQA) e design sem codificação de posição (NoPE), com dados de pré-treinamento que chegam a 112 trilhões de tokens, abrangendo dados da web, código, matemática e raciocínio. Seu design único de NoPE vem de uma pesquisa de 2023, visando eliminar a codificação de posição tradicional (como RoPE) para melhorar a generalização em sequências longas. Apesar de o SmolLM3-3B ter um tamanho de parâmetro entre o Qwen3-1.7B e o 4B, seu desempenho em modelos de 3B-4B é notável, especialmente em suporte a múltiplos idiomas (6 idiomas) e processamento de contexto longo.
O Qwen3-4B destaca-se com seu comprimento de contexto de 32.768 tokens e arquitetura de 36 camadas Transformer, mostrando grande potencial em implantações leves. O Qwen3-4B utilizou um conjunto de dados de aproximadamente 36 trilhões de tokens durante o pré-treinamento (o dobro do Qwen2.5), e otimizou a capacidade de inferência e codificação através de uma linha de produção de quatro etapas. A AIbase observou que o Qwen3-4B superou até mesmo o modelo Qwen2.5, que tem mais parâmetros, em tarefas de STEM, codificação e raciocínio, demonstrando o grande potencial dos modelos médios e pequenos em termos de eficiência e desempenho.
Llama3.2 e Kimi-K2: colisão entre clássico e inovação
O Llama3.2 (3B de parâmetros) continua com o design clássico da Meta AI, adotando uma arquitetura híbrida alternando entre camadas MoE e densas, com 2 especialistas ativos (cada especialista possui uma camada oculta de tamanho 8192). Em comparação com o design de 9 especialistas do DeepSeek-V3, o Llama3.2 possui menos especialistas, mas com maior escala, revelando uma estratégia conservadora na alocação de recursos computacionais. A AIbase observou que o Llama3.2 se destaca em tarefas de recuperação de informações e escrita criativa, mas está ligeiramente atrás do Qwen3 e do DeepSeek-V3 em tarefas de raciocínio complexo.
O Kimi-K2, com sua arquitetura MoE de 1 trilhão de parâmetros totais e 32 bilhões de parâmetros ativos, tornou-se um "gigante" no campo do código aberto. Ele se destaca em tarefas de programação autônoma, chamada de ferramentas e raciocínio matemático, com algumas métricas superando até o DeepSeek-V3. A estratégia de código aberto do Kimi-K2 (licença Apache 2.0) o tornou uma escolha popular para desenvolvedores e pesquisadores, embora exija hardware avançado para implantação. A AIbase acredita que a aparição do Kimi-K2 further impulsionou o uso da arquitetura MoE em modelos de grande escala, marcando um passo adiante na direção de maior desempenho e menor custo de inferência nos LLM de código aberto.
Tendências tecnológicas e perspectivas futuras
A AIbase acredita que em 2025, os LLM de código aberto apresentaram as seguintes tendências: primeiro, a arquitetura MoE, por sua eficiente utilização de parâmetros e vantagem na velocidade de inferência, está substituindo os modelos densos tradicionais; segundo, os modelos médios e pequenos alcançaram desempenho próximo ao dos grandes modelos por meio de otimizações em dados de treinamento e arquitetura; por fim, tecnologias inovadoras como o NoPE e a melhoria nas capacidades de processamento de contexto longo estão pavimentando o caminho para aplicações multimodais e multilíngues dos LLM.
Embora existam diferenças sutis entre os modelos, como número de especialistas, forma de codificação de posição e escala de dados de treinamento, ainda há necessidade de estudos adicionais para entender plenamente o impacto dessas diferenças no desempenho final. A AIbase sugere que os desenvolvedores devem ponderar o desempenho, o custo de inferência e a dificuldade de implantação ao escolher modelos. Por exemplo, usuários que buscam velocidade de inferência podem optar pelo DeepSeek-V3, enquanto aqueles que valorizam qualidade de saída e capacidade de tarefas múltiplas podem priorizar o Qwen3-235B-A22B.
A era dourada dos LLM de código aberto