蚂蚁百灵10月20日开源Ming-3.0语音系列,面向声音创作、长语音分析、业务语音转写,推出语音合成、音频理解与对话、语音识别共五款模型:tts的0.5B与tiny、audio的flash与tiny、asr-tiny。权重上架Hugging Face和ModelScope,Ling Studio提供API及在线体验。TTS的Voice Design可用文字描述音色或参考音频,导演模式支持文字控制。
千问发布Qwen-Audio-3.1系列语音大模型,全面升级语音识别、合成与实时交互,并推出音频创作模型TTS-Next与理解模型ASR-Next,五款模型覆盖“理解—生成—交互—创作”完整能力栈。同时全线降价,TTS降约70%,降低使用门槛。
阿里千问9月23日升级语音栈,推出Qwen-Audio-3.1系列五款模型,覆盖识别、合成、实时交互、音频创作与理解,形成“理解—生成—交互—创作”完整矩阵。价格大幅下调:TTS降约70%、Realtime降约85%、ASR降95%,大幅降低语音使用门槛。
千问9月23日发布Qwen-Audio-3.1系列语音大模型,形成覆盖理解、生成、交互与创作的完整音频能力栈,含ASR、ASR-Next、TTS、TTS-Next及Realtime。API已上架千问AI平台,ASR-Next即将上线。同步全线降价:TTS约70%、Realtime约85%、ASR达95%。ASR增强多语种、方言识别与上下文理解,新增原生转写润色。
Seed Audio AI 含 TTS、ASR 等,通过 API 为创作者和开发者生成音频
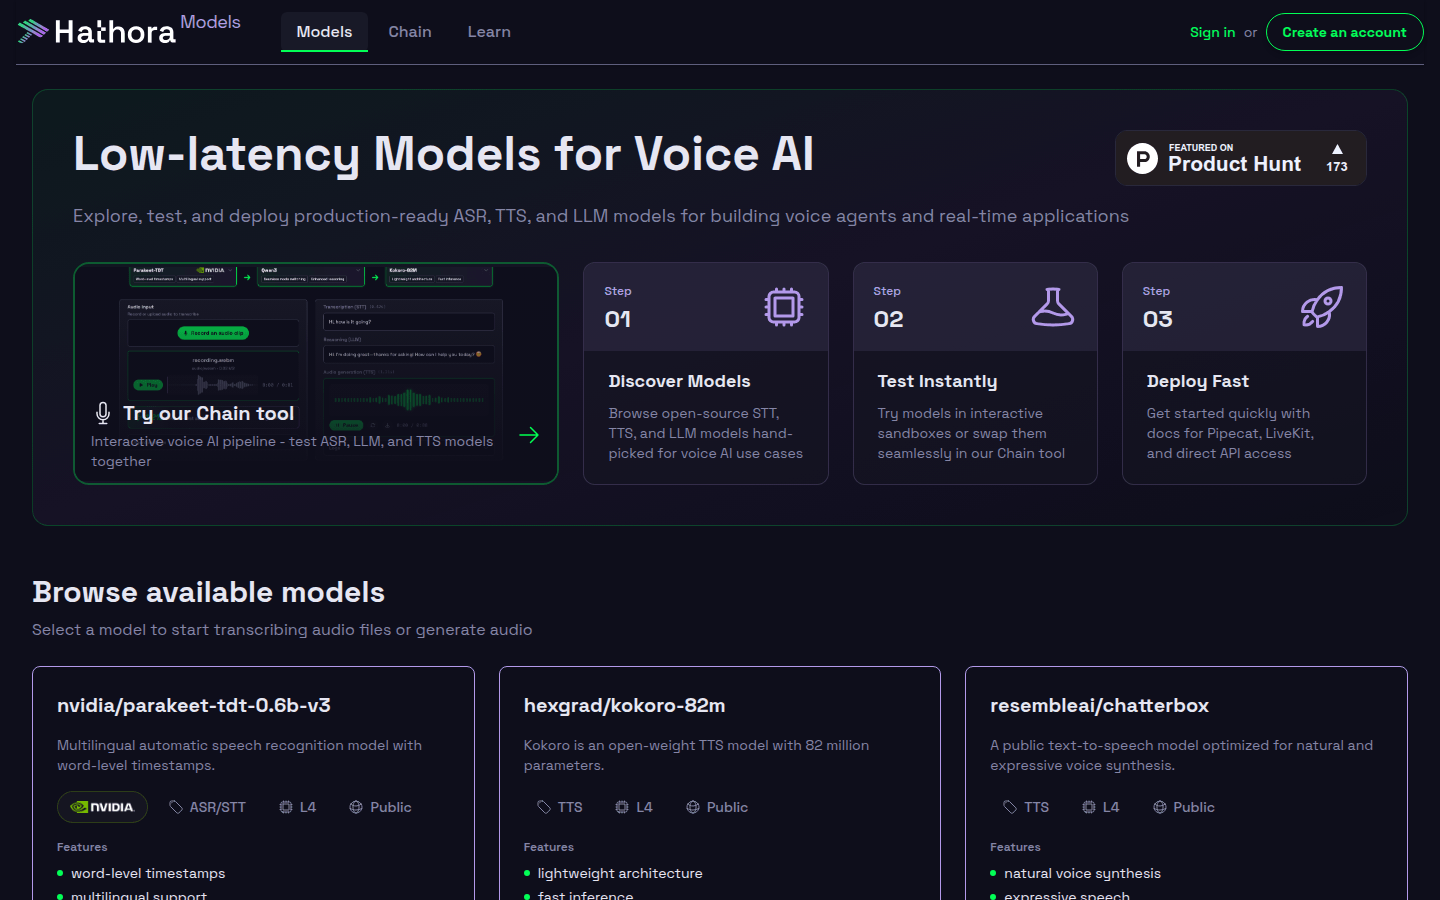
提供语音AI的ASR、TTS和LLM模型,可测试部署用于实时应用。
Nexa SDK可在数分钟内将AI模型部署到任何设备上,快速、私密且适用于多场景。
PengChengStarling 是一个基于 icefall 项目的多语言自动语音识别(ASR)模型开发工具包。
Anthropic
$7
输入tokens/百万
$35
输出tokens/百万
200
上下文长度
Alibaba
-
Chatglm
128
ai-sage
GigaAM-v3是基于Conformer架构的俄语自动语音识别基础模型,拥有2.2-2.4亿参数。它是GigaAM系列的第三代模型,在70万小时俄语语音数据上使用HuBERT-CTC目标进行预训练,在广泛的俄语ASR领域提供最先进的性能。
abr-ai
这是一个由Applied Brain Research(ABR)开发的基于状态空间模型(SSM)的英文自动语音识别模型,拥有约1900万参数,能够高效准确地将英文语音转录为文本。该模型在多个基准数据集上表现出色,平均单词错误率仅为10.61%,支持实时语音识别并可在低成本硬件上运行。
Vikhrmodels
Borealis 是首款面向俄语的自动语音识别(ASR)音频大语言模型,经过约7000小时俄语音频数据训练。该模型支持识别音频中的标点符号,架构受Voxtral启发但有所改进,在多个俄语ASR基准测试中表现优异。
openchs
基于OpenAI Whisper Large v2在Common Voice 17.0斯瓦希里语数据集上微调的语音识别模型,专为坦桑尼亚儿童求助热线的斯瓦希里语语音识别任务设计,相比基础模型在斯瓦希里语识别准确率上有显著提升。
MediaTek-Research
Breeze ASR 25 是一款基于 Whisper-large-v2 微调的先进自动语音识别模型,特别优化了台湾普通话和普通话-英语代码切换场景的识别能力。
unsloth
Whisper是一个预训练的自动语音识别(ASR)和语音翻译模型,通过68万小时标注数据训练,具有强大的泛化能力。
Whisper是OpenAI开发的最先进的自动语音识别(ASR)和语音翻译模型,在超过500万小时的标记数据上训练,具有强大的零样本泛化能力。Turbo版本是原版的修剪微调版本,解码层从32层减少到4层,速度大幅提升但质量略有下降。
Whisper是OpenAI开发的最先进的自动语音识别(ASR)和语音翻译模型,支持多种语言
istupakov
NVIDIA Parakeet TDT 0.6B V2 是一个基于自动语音识别(ASR)任务的模型,适用于英语语音转文本任务。
mlx-community
该模型是基于FastConformer架构的日语自动语音识别(ASR)模型,由NVIDIA开发并转换为MLX格式。
ibm-granite
Granite-speech-3.3-2b是IBM开发的紧凑高效语音语言模型,专为自动语音识别(ASR)和自动语音翻译(AST)设计,采用双通设计提高模块化和安全性。
GigaAM v2 是一个自动语音识别(ASR)模型,支持俄语语音转文本任务,提供CTC和RNN-T两种架构。
benax-rw
KinyaWhisper是基于OpenAI Whisper模型微调的卢旺达语自动语音识别(ASR)系统,专为低资源土著语言设计。
专为自动语音识别(ASR)和自动语音翻译(AST)设计的紧凑高效语音语言模型,采用双阶段设计处理音频和文本
Purfview
Distil-Whisper是Whisper模型的蒸馏版本,针对自动语音识别(ASR)任务进行了优化,提供更快的推理速度。
sbapan41
Quantum_STT 是一种先进的自动语音识别(ASR)和语音翻译模型,基于大规模弱监督训练,支持多种语言和任务。
asr-africa
基于facebook/w2v-bert-2.0微调的豪萨语语音识别模型,在500小时豪萨语数据上训练,词错误率7.47%
waveletdeboshir
GigaAM-v2-RNNT 是一个俄语自动语音识别(ASR)模型,基于RNNT架构,适用于语音转文本任务。
Granite-speech-3.2-8b 是一款紧凑高效的语音语言模型,专为自动语音识别(ASR)和自动语音翻译(AST)设计。
pluttodk
目前最快的丹麦语ASR模型,是hviske-v2的蒸馏版本,速度提升约4倍且保持准确率不变。
ASR MCP服务器是一个基于whisper引擎的自动语音识别服务,通过MCP工具提供语音合成功能,便于应用集成。
%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23061b40;%20}%20.st1%20{%20fill:%20%23306af1;%20}%20.st2%20{%20fill:%20%235ce5cf;%20}%20%3c/style%3e%3c/defs%3e%3cg%3e%3cpath%20class='st0'%20d='M55,10.5h9v3h-9v9h12V7.5h-12v3ZM64,19.5h-6v-3h6v3Z'/%3e%3cpolygon%20class='st0'%20points='69%2016.5%2078%2016.5%2078%2019.5%2069%2019.5%2069%2022.5%2081%2022.5%2081%2013.5%2072%2013.5%2072%2010.5%2081%2010.5%2081%207.5%2069%207.5%2069%2016.5'/%3e%3cpolygon%20class='st0'%20points='95%2010.5%2095%207.5%2083%207.5%2083%2022.5%2095%2022.5%2095%2019.5%2086%2019.5%2086%2016.5%2095%2016.5%2095%2013.5%2086%2013.5%2086%2010.5%2095%2010.5'/%3e%3cpath%20class='st0'%20d='M40,1.5v21h11.6l1.4-1.4v-7.6h0c0,0-1.4-1.5-1.4-1.5l1.4-1.4V2.9l-1.4-1.4h-11.6ZM50,19.5h-7v-6h7v6ZM50,10.5h-7v-6h7v6Z'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M23.1,24L14.7,4.8l-4.9,11.2h3.8l-1.8,4H3.3L12.1,0H2C.9,0,0,.9,0,2v20c0,1.1.9,2,2,2h21.1Z'/%3e%3cpath%20class='st2'%20d='M34,0h-16.8l10.6,24h6.2c1.1,0,2-.9,2-2V2C36,.9,35.1,0,34,0ZM32.5,20h-4V4h4v16Z'/%3e%3c/svg%3e)
 VIP会员