千问发布Qwen-Audio-3.1系列语音大模型,全面升级语音识别、合成与实时交互,并推出音频创作模型TTS-Next与理解模型ASR-Next,五款模型覆盖“理解—生成—交互—创作”完整能力栈。同时全线降价,TTS降约70%,降低使用门槛。
阿里千问9月23日升级语音栈,推出Qwen-Audio-3.1系列五款模型,覆盖识别、合成、实时交互、音频创作与理解,形成“理解—生成—交互—创作”完整矩阵。价格大幅下调:TTS降约70%、Realtime降约85%、ASR降95%,大幅降低语音使用门槛。
新一代同声传译大模型Qwen3.8-LiveTranslate全面升级翻译质量、延迟、说话人识别和语音合成。采用音频-文本交织Interleave架构,将流式理解、文本输出与语音生成整合为单条因果序列,字均延迟从2.8秒压缩至2.3秒。新增实时说话人分离,多人交替发言归属清晰,译文语音可稳定保留原说话人音色。
谷歌发布新一代实时语音大模型Gemini3.8 Live及扩展思考版,实现原生端到端音频交互突破,降低对话延迟、提升自然度,并首次在低延迟语音流中支持深层多步推理,重塑复杂专业场景下的语音AI应用范式。
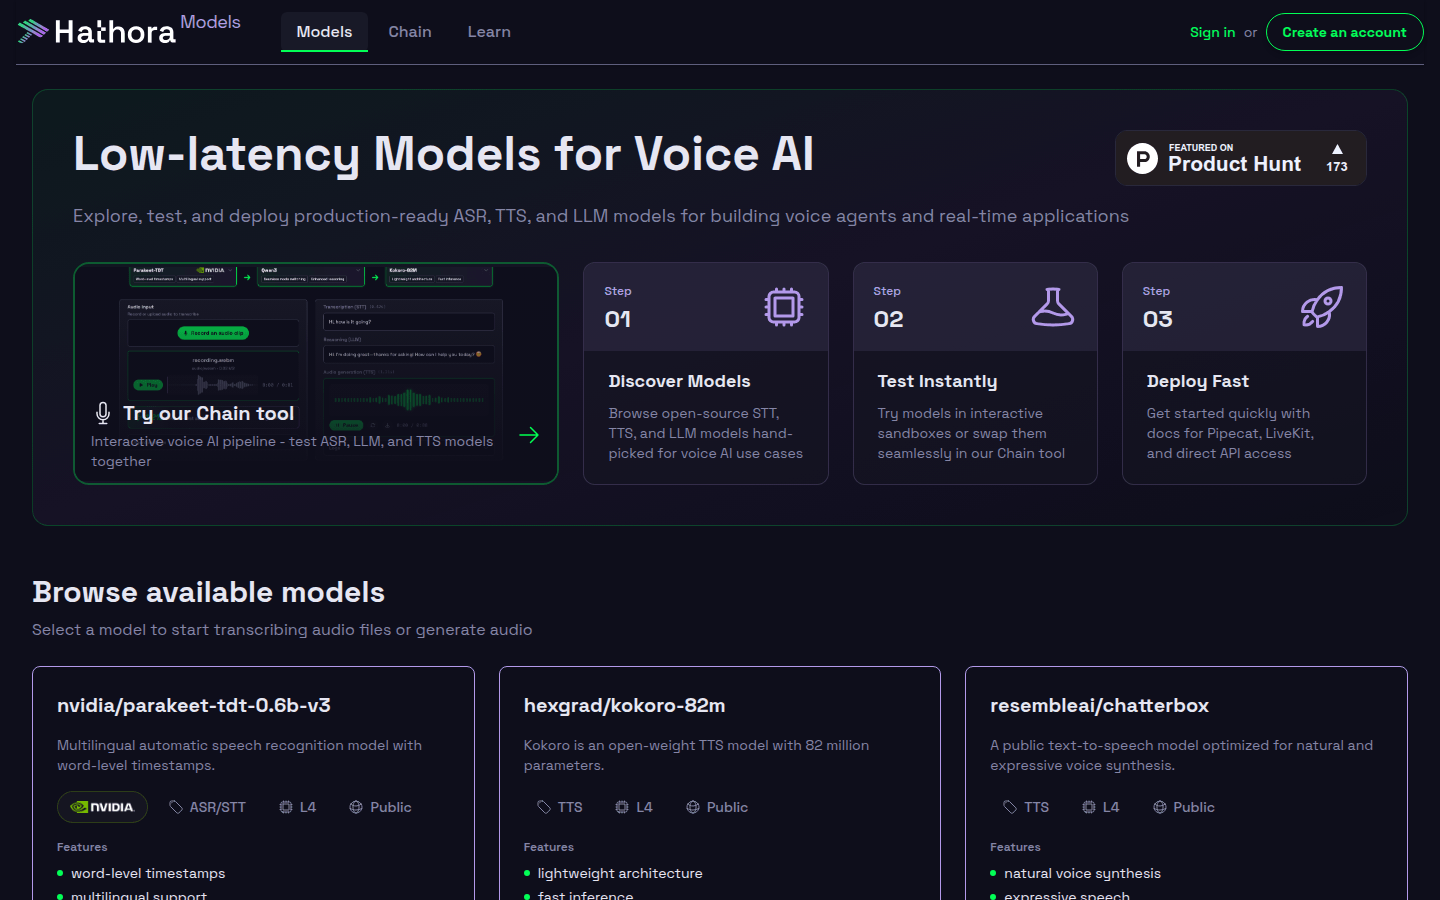
提供语音AI的ASR、TTS和LLM模型,可测试部署用于实时应用。
VITA-1.5: 实时视觉和语音交互的GPT-4o级多模态大语言模型
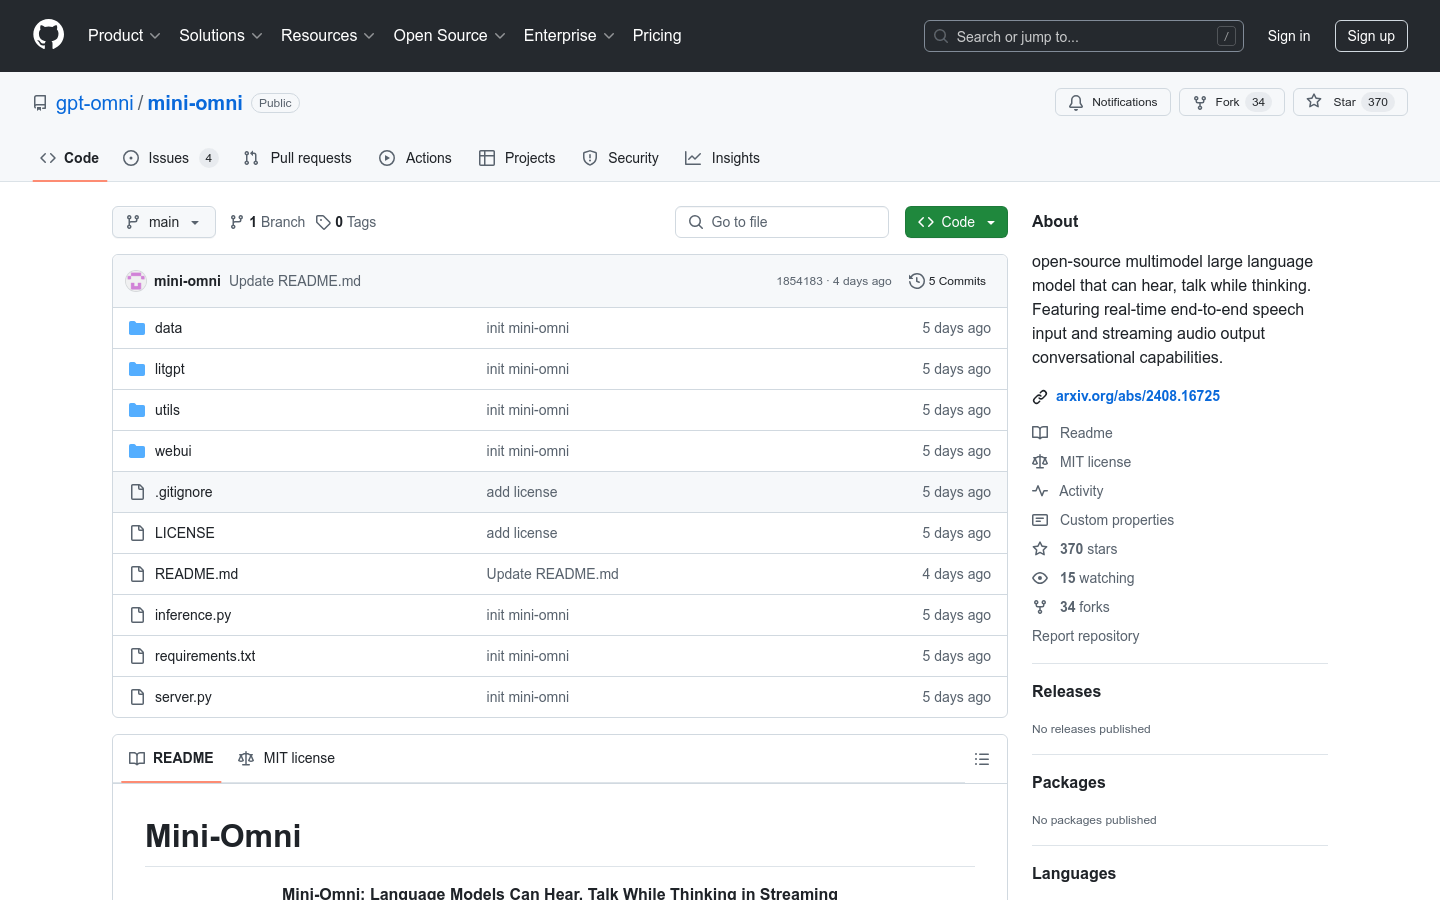
开源多模态大型语言模型,支持实时语音输入和流式音频输出。
Openai
$2.8
输入tokens/百万
$11.2
输出tokens/百万
1k
上下文长度
Google
$0.49
$2.1
Xai
$1.4
$3.5
2k
$7.7
$30.8
200
-
Anthropic
$105
$525
$0.7
$7
$35
$17.5
$21
Alibaba
$4
$16
$1
$10
256
Baidu
128
$2
$20
$6
$24
$8
$240
52
Bytedance
$1.2
$3.6
4
nineninesix
KaniTTS是一款专为实时对话式AI应用优化的高速、高保真文本转语音模型,采用两阶段管道结合大型语言模型和高效音频编解码器,实现卓越的速度和音频质量。该模型支持西班牙语,具有4亿参数,采样率为22kHz。
KaniTTS是一款专为实时对话式人工智能应用优化的高速、高保真阿拉伯语文本转语音模型。它采用两阶段流水线架构,结合大语言模型与高效音频编解码器,实现卓越的速度和音频质量,能够满足对话式AI、无障碍辅助、研究等多领域的语音合成需求。
KaniTTS是一款专为实时对话式AI应用优化的高速、高保真文本转语音模型,通过独特的两阶段架构结合大语言模型与高效音频编解码器,实现低延迟与高质量语音合成,实时因子低至0.2,比实时速度快5倍。
KaniTTS Pretrain v0.3是一款高速、高保真的文本转语音模型,专为实时对话式人工智能应用优化,采用两阶段管道架构,结合大语言模型和高效音频编解码器,实现极低延迟和高品质语音合成。
KaniTTS是一款专为实时对话式AI应用优化的高速、高保真文本转语音模型。它采用两阶段流水线架构,结合大语言模型和高效音频编解码器,实现了卓越的速度和音频质量,支持多种语言并适用于边缘/服务器部署。
KaniTTS是一款高速、高保真的文本转语音模型,专为实时对话式人工智能应用而优化。该模型采用两阶段处理流程,结合大语言模型和高效音频编解码器,在Nvidia RTX 5080上生成15秒音频的延迟仅需约1秒,MOS自然度评分达4.3/5,支持英语、中文、日语等多种语言。
neuphonic
NeuTTS Air是世界上首个具备即时语音克隆功能的超逼真、端侧文本转语音(TTS)语言模型。基于0.5B参数的大语言模型骨干构建,能为本地设备带来自然的语音、实时性能、内置安全性和说话人克隆功能。
NeuTTS Air是全球首个具有即时语音克隆功能的超逼真设备端文本转语音模型,基于0.5B参数的大语言模型骨干构建,能在本地设备上实现自然语音生成、实时性能和说话人克隆功能。
NeuTTS Air是世界上首个具备即时语音克隆功能的超逼真、设备端文本转语音(TTS)语言模型。基于0.5B大语言模型骨干网络构建,能为本地设备带来自然的语音、实时性能、内置安全功能和说话人克隆能力。
Prince-1
基于Llama架构的语音大模型,专为高质量文本转语音设计,支持情感控制和实时流式传输
maitrix-org
Voila是一个大型语音-语言基础模型家族,旨在提升人机交互体验,支持实时、低延迟的语音交互和多语言处理。
%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23061b40;%20}%20.st1%20{%20fill:%20%23306af1;%20}%20.st2%20{%20fill:%20%235ce5cf;%20}%20%3c/style%3e%3c/defs%3e%3cg%3e%3cpath%20class='st0'%20d='M55,10.5h9v3h-9v9h12V7.5h-12v3ZM64,19.5h-6v-3h6v3Z'/%3e%3cpolygon%20class='st0'%20points='69%2016.5%2078%2016.5%2078%2019.5%2069%2019.5%2069%2022.5%2081%2022.5%2081%2013.5%2072%2013.5%2072%2010.5%2081%2010.5%2081%207.5%2069%207.5%2069%2016.5'/%3e%3cpolygon%20class='st0'%20points='95%2010.5%2095%207.5%2083%207.5%2083%2022.5%2095%2022.5%2095%2019.5%2086%2019.5%2086%2016.5%2095%2016.5%2095%2013.5%2086%2013.5%2086%2010.5%2095%2010.5'/%3e%3cpath%20class='st0'%20d='M40,1.5v21h11.6l1.4-1.4v-7.6h0c0,0-1.4-1.5-1.4-1.5l1.4-1.4V2.9l-1.4-1.4h-11.6ZM50,19.5h-7v-6h7v6ZM50,10.5h-7v-6h7v6Z'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M23.1,24L14.7,4.8l-4.9,11.2h3.8l-1.8,4H3.3L12.1,0H2C.9,0,0,.9,0,2v20c0,1.1.9,2,2,2h21.1Z'/%3e%3cpath%20class='st2'%20d='M34,0h-16.8l10.6,24h6.2c1.1,0,2-.9,2-2V2C36,.9,35.1,0,34,0ZM32.5,20h-4V4h4v16Z'/%3e%3c/svg%3e)
 VIP会员